
L’arrivée des IA génératives dans le développement logiciel nous amène à repenser une question que nous pensions pourtant bien maîtriser : comment préserver le patrimoine logiciel d’une entreprise dans le temps ?
Cette réflexion est née récemment lors d’un échange avec notre équipe de développement.
Nous parlions d’IA générative, de Claude Code, de ChatGPT Codex, de Git / SVN, de documentation et surtout de la façon dont nous devrions structurer nos futurs projets.
La discussion nous a amenés à une question assez simple :
Qu’est-ce qu’une entreprise doit réellement préserver pour être capable de maintenir un logiciel dans 3, 5 ou 10 ans ?
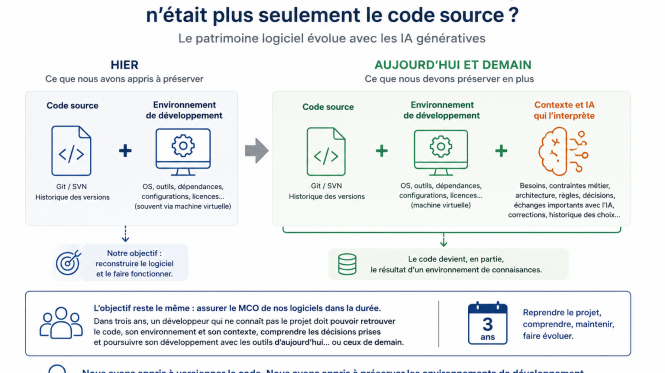
Historiquement : préserver le code et son environnement de développement
Pendant longtemps, nous avons essentiellement conservé deux choses : le code source et l’environnement permettant de le développer et de le reconstruire.
Le premier élément paraît évident. Git, SVN et les autres systèmes de gestion de versions nous permettent de conserver l’historique des sources et de revenir précisément à un état donné du logiciel.
Mais le code seul n’est déjà pas suffisant.
Il faut également être capable de retrouver l’environnement qui permet de le compiler, de l’exécuter, de le tester et de générer les livrables.
Lorsque cet environnement de développement est virtualisé, conserver la machine virtuelle permet par exemple de préserver l’OS, les versions des outils, les dépendances et les configurations spécifiques.
Bref, de retrouver plusieurs années plus tard l’environnement technique du développeur.
L’équation était finalement assez simple :
Code source + environnement de développement = nous pensions avoir l’essentiel.
L’IA générative introduit un troisième élément : le contexte
Avec l’utilisation croissante des IA génératives pour développer des logiciels, je pense qu’il faut désormais ajouter quelque chose à cette équation :
le contexte… et l’IA qui l’interprète.
Car lorsqu’un développeur travaille avec une IA, le code produit ne dépend plus uniquement de son environnement de développement.
Il dépend aussi des informations données au modèle : besoins fonctionnels, contraintes métier, architecture logicielle, règles de développement, décisions techniques, échanges importants avec l’IA, corrections successives, historique des choix…
Tous ces éléments participent désormais, directement ou indirectement, à la production du code.
Le code devient ainsi, en partie, le résultat d’un environnement de connaissances.
Conserver les sources ne signifie plus nécessairement conserver tout le projet
C’est probablement le point qui nous interroge le plus.
Imaginons que nous devions reprendre un projet dans cinq ans.
Nous avons conservé son dépôt Git.
Nous avons conservé la machine virtuelle permettant de retrouver exactement son environnement de développement.
Nous avons même conservé sa documentation.
Mais nous avons perdu le contexte utilisé pendant son développement assisté par IA : les décisions, les règles données au modèle, certains échanges importants et les raisons ayant conduit à tel ou tel choix d’architecture.
Avons-nous réellement conservé tout ce qui est nécessaire pour reprendre efficacement le projet ?
Je pense que la réponse est de moins en moins évidente.
Le dépôt comme mémoire du projet, et plus seulement du code
Cette réflexion nous amène donc à regarder différemment nos dépôts logiciels.
Un dépôt ne devrait peut-être plus seulement être la mémoire du code.
Il pourrait également devenir la mémoire structurée du contexte nécessaire pour comprendre ce code, le maintenir et continuer à le faire évoluer.
Il ne s’agit évidemment pas de conserver aveuglément toutes les conversations avec une IA.
L’enjeu est plutôt d’identifier ce qui constitue réellement la connaissance du projet et mérite d’être capitalisé : règles, contexte, décisions d’architecture, choix techniques, informations nécessaires à la reprise du développement, mais aussi tests, documentation et processus d’intégration et de build.
Nous ne parlons donc plus seulement de sauvegarder du code.
Nous parlons progressivement de préserver un patrimoine logiciel composé du code, de son environnement et de la connaissance qui a permis de le produire.
Un nouvel enjeu pour le maintien en condition opérationnelle des logiciels
L’objectif reste finalement celui de n’importe quelle équipe de développement : assurer le maintien en condition opérationnelle de ses logiciels dans la durée.
On pourrait le résumer par un test assez simple :
Dans trois ans, un développeur qui ne connaît pas le projet doit pouvoir retrouver le code, son environnement et son contexte, comprendre les décisions prises et poursuivre son développement avec les outils d’aujourd’hui… ou ceux de demain.
Nous avons appris à versionner le code.
Nous avons appris à préserver les environnements de développement.
Avec les IA génératives, nous allons devoir apprendre à versionner le contexte qui permet de produire le logiciel.
Et c’est peut-être l’un des prochains défis du génie logiciel


